




Meta の Muse を指揮者にして、Claude/Codex/Hermes という複数の AI をサブスクのまま編成し、EA を作った。今回は、その仕事をどう回したかを記録しておきたい。
ここで扱うのは、EA の個別ロジックの中身ではない。候補を誰に渡し、何を成果物として受け取り、どこで落とし、担当が止まったときにどう引き継いだか。つまり、チームの編成と検証の手順だ。Williams と Market Profile のロジック解説は、それぞれ別の記事に譲る。
実際に回してみると、コードを書くだけでは仕事は終わらなかった。仕様をそろえ、計算結果を確かめ、MT4 上の実装と参照値を照合する必要がある。AI が「完了した」と言うことと、私が次の工程へ進めると判断できることの間には、必ず検収が挟まる。この部分も含めてのオーケストレーションだった。
3層の編成
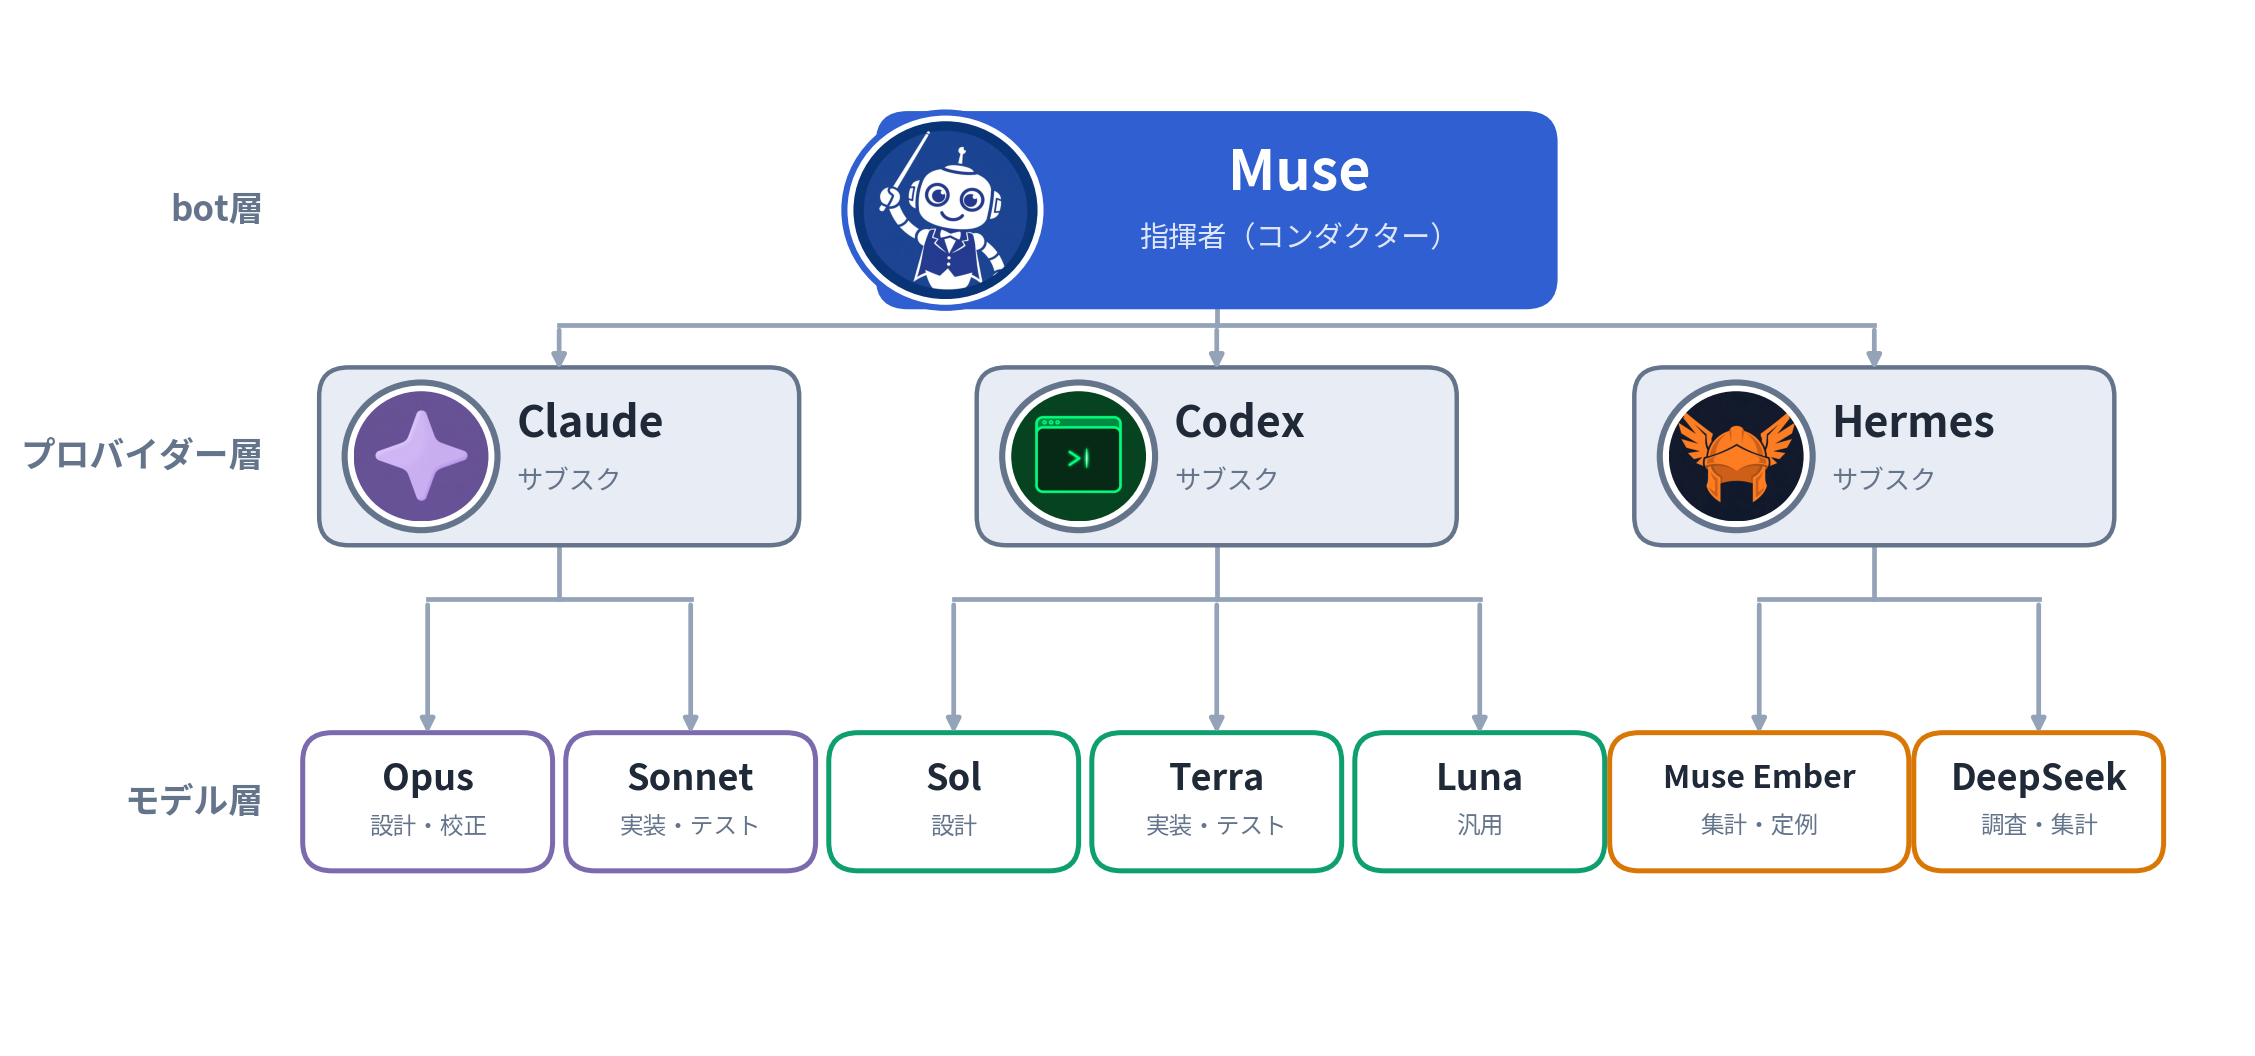
全体は、bot 層、プロバイダー層、モデル層の3層で考えている。層を分けておくと、誰が仕事を指揮するのか、どの契約の枠で動かすのか、実際にどのモデルが担当するのかを整理できる。
bot 層にいる Muse は指揮者(コンダクター)だ。課題を分解して担当へ振り分け、戻ってきた成果物を検収する。担当が失敗したときの引き継ぎと、最終報告までを受け持つ。今回の仕事では、共通仕様の固定や、計算結果の CSV からの機械集計も指揮側の役割になった。
プロバイダー層は、Claude Pro や ChatGPT Plus など、契約済みのサブスクリプションだ。その枠の中で CLI を動かす。
モデル層では、役割ごとに用意した席にモデルを差し込む。新しいモデルが出たら、その席に入れて小さな課題で試し、合えばそのまま使う。ポイントは「モデルを買い替える」のではなく、「席に差し込む」と考えることだ。
ただし、席を用意したからといって、判断まで AI に渡すわけではない。判断と上限は私が握る。AI の完了報告は信じず、成果物(ファイルや数値)が実在するかで判定する。
この考え方は、担当を入れ替えるときにも効いてくる。指揮側が受け取るのは担当の説明ではなく、計算結果や実装そのものだ。今回も担当が止まったあとは、残りの計算を引き取り、CSV を集計し直してから検収した。
検証の進め方(10ステップ)
候補2本で実際に回した流れを、あとから10ステップに整理して固定した。以後の検証もこの順で進める。前提として、候補は無料・オープンソースのロジックから選び、対象は MT4 で扱える銘柄に限る。
① 設計
ロジックの運用定義を文書に固定し、原典の曖昧さを先に潰す。
② 実装
Python で検証コードを書く。往復コスト3pips、集計は全期間と当年を分離する、といった共通規約は全候補で統一する。
③ テスト
適当なパラメータで試し実行し、バグを出す。グリッドを回す前に、まず実装がまともに動くことを確かめる工程だ。
④ グリッドバックテスト
SL/TP をそれぞれ10〜150pips、5pips 刻みで動かし、全841通りを計算する。良いセルがあるかどうかと、良い結果が「面」としてどれだけ広がっているかで一次判定する。
⑤ 統計分析
勝敗をトレンド方向、ボラティリティ帯、曜日などの環境で切り分ける。全期間と当年で符号が一致する切り口だけを、フィルターの候補にする。
⑥ フィルター適用・効果予測
既存の取引を事後抽出し、フィルターを入れた場合の効果を見積もる。ここで出るのは、あくまで予測だ。
⑦ フィルターバックテスト
フィルターを実際の判定ループに組み込んで再計算し、閾値の近傍でも面で持つか(感度)を確認する。⑥と分けたのは、取引を飛ばすと後続のエントリー自体が変わるためで、この分離は私の指摘で追加した工程だ。
⑧ 収益曲線比較
フィルターなし、フィルターあり、感度ベストの収益曲線を重ねて目視で確認する。
⑨ MQL実装
MT4 用に書き直し、別系統のモデルによる独立レビューを受けてから配置する。
⑩ MT4ストラテジーテスト
テスターは私が実施し、最終判定する。Python 側の参照値と近ければ「実装が一致した」とみなし、通過したものをフォワードテストへ進める。
役割分担
EA 作成で実際に使った役割は次のとおりだ。設計・実装と実行・テストを分け、指揮側が共通仕様と検収を受け持った。
担当の分け方は、こうした。候補12本の設計・実装は、Claude 側の Opus と GPT 側の Sol が6本ずつ分担した。作業は、候補4本をひとまとめにして3回に分けて進めた。この、並行して進めるひとまとめを「バッチ」と呼んでいる。1つのバッチでは、Opus と Sol が2本ずつを受け持ち、同時に進めた。グリッドの実行も、Claude 側の Sonnet と GPT 側の Terra で分担している。
| 仕事 | 担当 |
|---|---|
| 全体の指揮・振り分け、共通仕様の固定、検収(計算結果CSVからの機械集計)、担当が落ちたときの引き継ぎ | Muse(bot層) |
| 設計・実装(Python検証コードの作成) | Opus 5.5(候補 01・02・05・06・09・10)/ GPT 6.1 Sol(候補 03・04・07・08・11・12) |
| 実行・テスト(グリッドバックテスト) | Sonnet 5.5(Claude側)/ GPT 6.1 Terra(Codex側) |
| クロスチェック(担当を入れ替えた独立再実装) | 第1バッチのみ実施(Williams の数値が完全一致した) |
| MQL実装の独立レビュー | Sol(07 Market Profile の実装レビュー15件を反映) |
| MT4ストラテジーテストの実施、最終判定(採用・フォワード開始) | 人間 |
クロスチェックは第1バッチだけで、すべての候補に実施したわけではない。また、独立レビューを受けたからといって実装の確認が終わるわけでもなかった。後述するコンパイルの問題は、この役割表の先に「実際に動かして確かめる」工程が必要だったことを示している。
表の最後の行、つまりテスターの実施と採用の判断は私が受け持った。AI 側が出すのは、参照値と一致したかどうかという照合結果まで。それを受けて採用するか、いつ実口座に出すかを決めるのは、私の仕事として残した。
12本から2本へ(採用・不採用の経緯)
EA の細部には触れず、数の流れだけを書く。
最初に、無料・オープンソースのロジックから12本を選んだ。そのうち02・03・04・10・11の5本は、841通りのグリッドで合格セルがひとつもなく、その場で不採用になった。
06のカルマンは、パラメータを固定した条件での不採用だった。そこで私は、核となるパラメータ自体を疑うべきだと指摘し、それを振る再スキャンを2026-11-13に追加で実施した。それでも合格はなく、不採用が確定して終了した。
08の COT は取引が7件しか発生せず、判定不能とした。落とすのでも通すのでもなく、評価の形式自体が合わなかったという扱いだ。
05・09・12の3本は保留にした。期間によって成績の符号が割れる、標本が少ない、といった理由による。09は次の1月にフォワードで確認する予定だ。
手順⑦まで進んでフィルターの効果を確認できた01の Williams と07の Market Profile の2本だけが、⑨MQL実装と⑩テスター照合に進んだ。両方とも合格して採用し、2026-11-16(月)から実口座でフォワード運用を始める。
数の流れをまとめると、「12本 → 2本採用・3本保留・6本不採用・1本判定不能」となる。
落とす判断のほうが多かった。そして、その落とし方まで手順に残せたことが、この検証の一番の収穫だった。全期間と当年で分ける。ひとつの良いセルではなく面で見る。核パラメータを疑う。こうした判断の型が、次の候補にもそのまま使える。
なお、最終判定は常に私が行った。AI 側は「参照値と一致した」という照合結果までを出し、採用とフォワード開始は私が決めた。
かかった時間
ここに挙げる時間は、ファイルの生成時刻から読める目安だ。
スクリーニング第2バッチ(候補4本)は、実装がそろってからグリッド完了まで約15分だった。4本を並行で回している。
同じく候補4本の第3バッチは約40分かかった。これには、Terra のセッション消失で1本のグリッドが遅れた分も含まれている。
2026-11-13 夜の06の再スキャンは、計算自体は数分で終わった。大半の時間は、何を疑うかの設計と、出てきた結果の照合に使った。
記事づくりの記録もある。2026-11-15 の Williams 解説記事は、依頼から原稿完成とロジック図の作成まで約8分、WordPress の下書き投入まで含めて約18分だった。MarketProfile の記事は、同じ手順で下書きまで約12分で終わった。
正直に書いておくと、EA 検証の工程ごとの分単位の計測はしていない。体感としては、計算そのものより「仕様を固定する」「数値を照合する」「落ちた担当の仕事を引き継ぐ」に時間を使った。オーケストレーションの手間は、モデルの実行時間ではなく、検収と引き継ぎに出る。
トラブルの記録
Terra のセッション消失(計3回)
第1バッチでは、Codex 側の入出力異常と Rust パニックで Terra のセッションが落ち、担当していた候補のグリッドが止まった。同じバッチで Sonnet 側もランタイム再起動に巻き込まれ、1銘柄を終えた時点で切れている。
第3バッチでは、Terra のセッションが再起動で消失し、候補11のグリッド2件が未完になった。担当に渡した仕事でも、そのセッションが最後まで生きているとは限らない。
対処はすべて同じ型だ。指揮側の Muse が残りを引き取って直接実行し、数値はすべて計算結果の CSV から機械集計し直して検収した。候補11では高速な等価計算で代替したが、元のコードと複数のセルで完全一致することを確認してから採用している。
このときの私の評は、「数十分の実行でもセッションが2回落ちた。期待はずれ。まあ出たばかりなので様子見」だった。
これを受けて運用ルールを変えた。重いグリッドなどの実行は当面 Sonnet か Muse 自身が回し、Terra には短時間の軽い作業だけを任せる。担当の信頼度に応じて仕事の重さを変える、という形で席の設計に反映した。
静的レビューでは見つからないバグ
MT4 化した EA が、変数名に予約語の defined を使っていたため、コンパイルエラーになった。別系統のモデルである Sol の静的レビューでは、これを見逃していた。
対処は、変数名を変更して再配置し、実際にコンパイルして0エラー・0警告を確認することだった。「レビューで通った」と「コンパイルが通った」は別物。実コンパイルとテスター結果で確かめる、という教訓を検証手順に刻んだ。
似た話がもうひとつある。テスターのレポートのファイル名が「Williams」なのに、中身が別の EA の結果だったことが2回あった。以後はファイル名ではなく、レポート内の EA 名・マジックナンバー・期間を確認してから数値を読むことにしている。
レビューの結果もファイル名も、それだけでは検収の根拠にならない。実際に動かした結果と、それが対象の EA のものであることまで確かめて、初めて成果物を受け取ったと言える。
短い期間のテスター結果に騙されかけた話
Market Profile の最初のテスターは短い期間で回したため、成績が悪く出た(PF 0.92)。原因は期間の長さそのものではなく、フィルターに必要な過去データ(ウォームアップ)が、期間の開始で切断されていたことだった。
長い期間で回し直すと、全エントリーが Python の参照と一致し、PF 1.27 で合格した。
教訓は、悪い結果を見たら、まず「測り方」を疑うこと。今回なら、フィルターが必要とする過去データをテスター期間の切り方で失っていないか、を最初に確認すべきだった。
まとめ
速いモデルに全部任せるのではなく、席を分けて、検収を機械化して、落ちたら指揮側が引き取る。この3点が回れば、モデルの入れ替えは怖くない。
トラブルも、モデルの性能問題とは限らなかった。セッションが消える。測る期間の切り方で必要な過去データが途切れる。ファイル名と中身が一致しない。オーケストレーションの仕事の半分は、こうした「モデル以前」の事故処理だった。
そして最後に残るのは、人間の仕事だ。何を候補にするか、どこで落とすか、いつ実口座に出すか。その判断は、これからも私が引き受ける。
コメント